Rust 製 CLI とライブラリ  /  MIT

モデルが自信を持てなかった単語を見つける。

トークンの対数確率(logprobs)付きの LLM の回答を渡すだけ。モデルの信頼度が下がった単語にフラグを付け、代わりに言いかけていた候補を表示します。保存したレスポンスをオフラインで解析することも、OpenAI 互換 API にその場で問い合わせることもできます。

cargo install llm-token-visualizer

Windows 版をダウンロード (.exe)

Rust が入っていれば上のコマンドでも OK。macOS と Linux 版は最新リリースにあります。

フラグ付きのスパンと、モデルが検討した候補

Llama 3.1 8B Instruct の実際のレスポンスで、examples/logprobs/ に同梱しています。検出は CLI と同じルールでブラウザ内で動きます。単語にカーソルを合わせるかタップすると、確率と候補が表示されます。OpenAI、OpenRouter、Together の API キーがあれば、ブラウザから自分の質問を試せます。

ターミナルで

コマンドひとつ、API キー不要。

保存済みの Chat Completions レスポンスを指定するだけ。回答はヒートマップで表示され、フラグ付きの各スパンには最も弱いトークンでの候補が並びます。--fail-on-flag を付ければ CI のゲートになります。
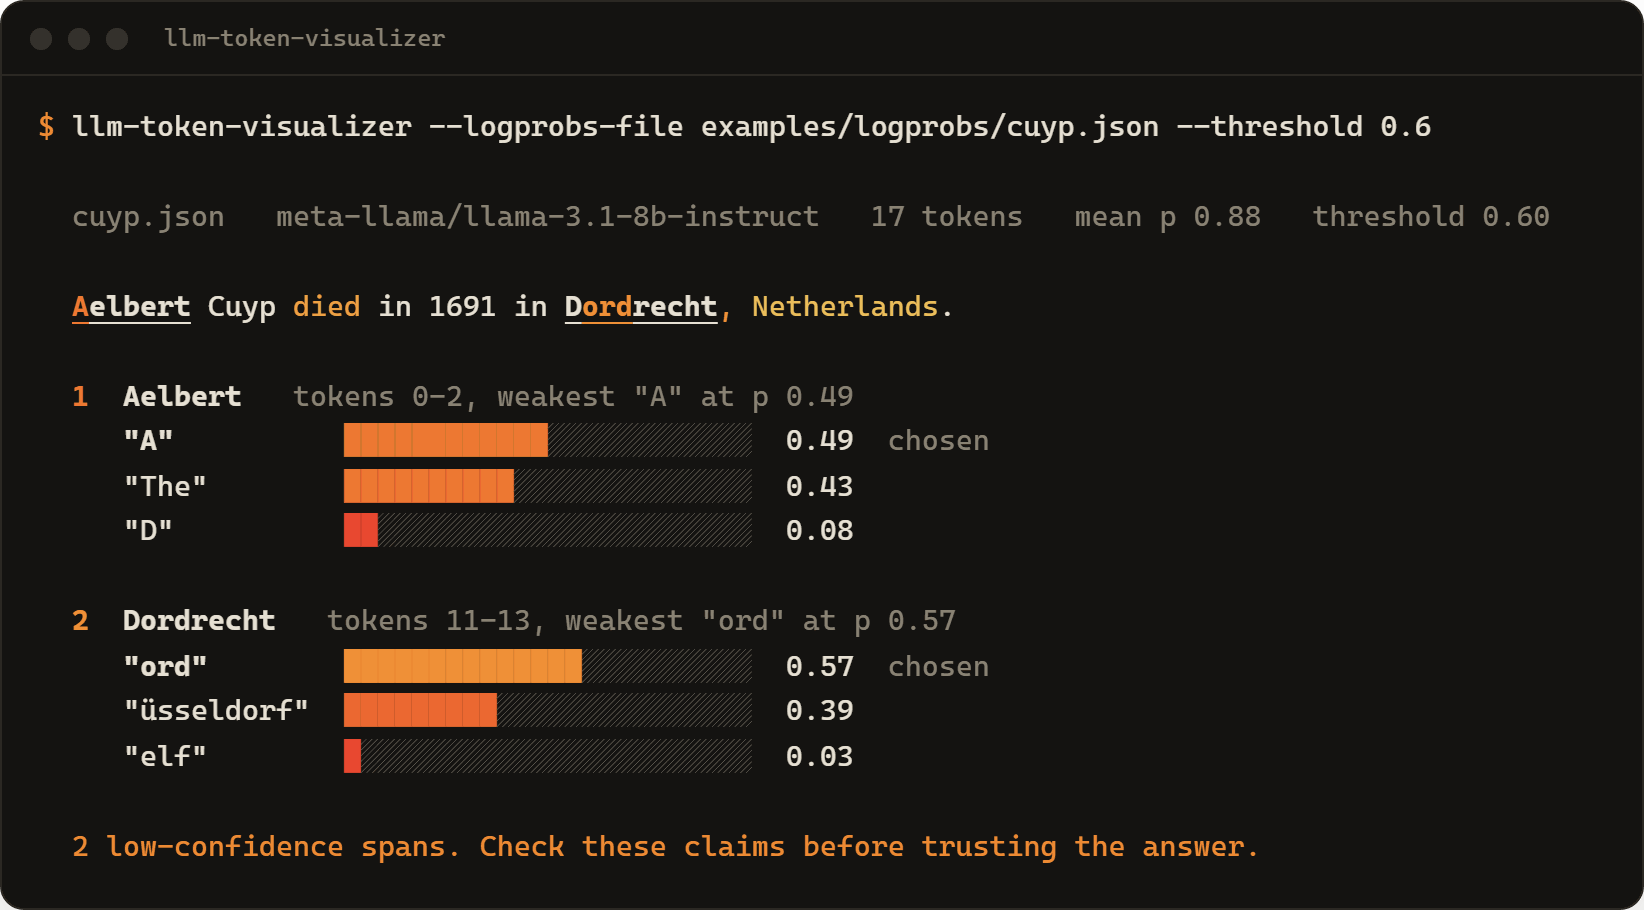
cuyp サンプルのターミナル出力。回答の Aelbert と Dordrecht に下線が引かれ、その下に候補のバー:A 0.49、The 0.43、D 0.08 と ord 0.57、üsseldorf 0.39、elf 0.03。
llm-token-visualizer --logprobs-file examples/logprobs/cuyp.json --threshold 0.6
git clone https://gitlab.com/mattbusel/LLM-Hallucination-Detection-Script
# offline, on a bundled real response
cargo run -- --logprobs-file examples/logprobs/cuyp.json --threshold 0.6

# all four samples through the library API
cargo run --example detect

# live: ask a model, analyze its answer
export OPENAI_API_KEY=sk-...
cargo run -- --live "Who was the second person to walk on the Moon?" \
  --save answer.json

ライブモードにはプリセットがあります:--provider openai、openrouter、together、vllm、ollama(ローカル、キー不要)。logprobs を返すサーバーなら --base-url でどれでも使えます。Anthropic の API は logprobs を返しません。
仕組み

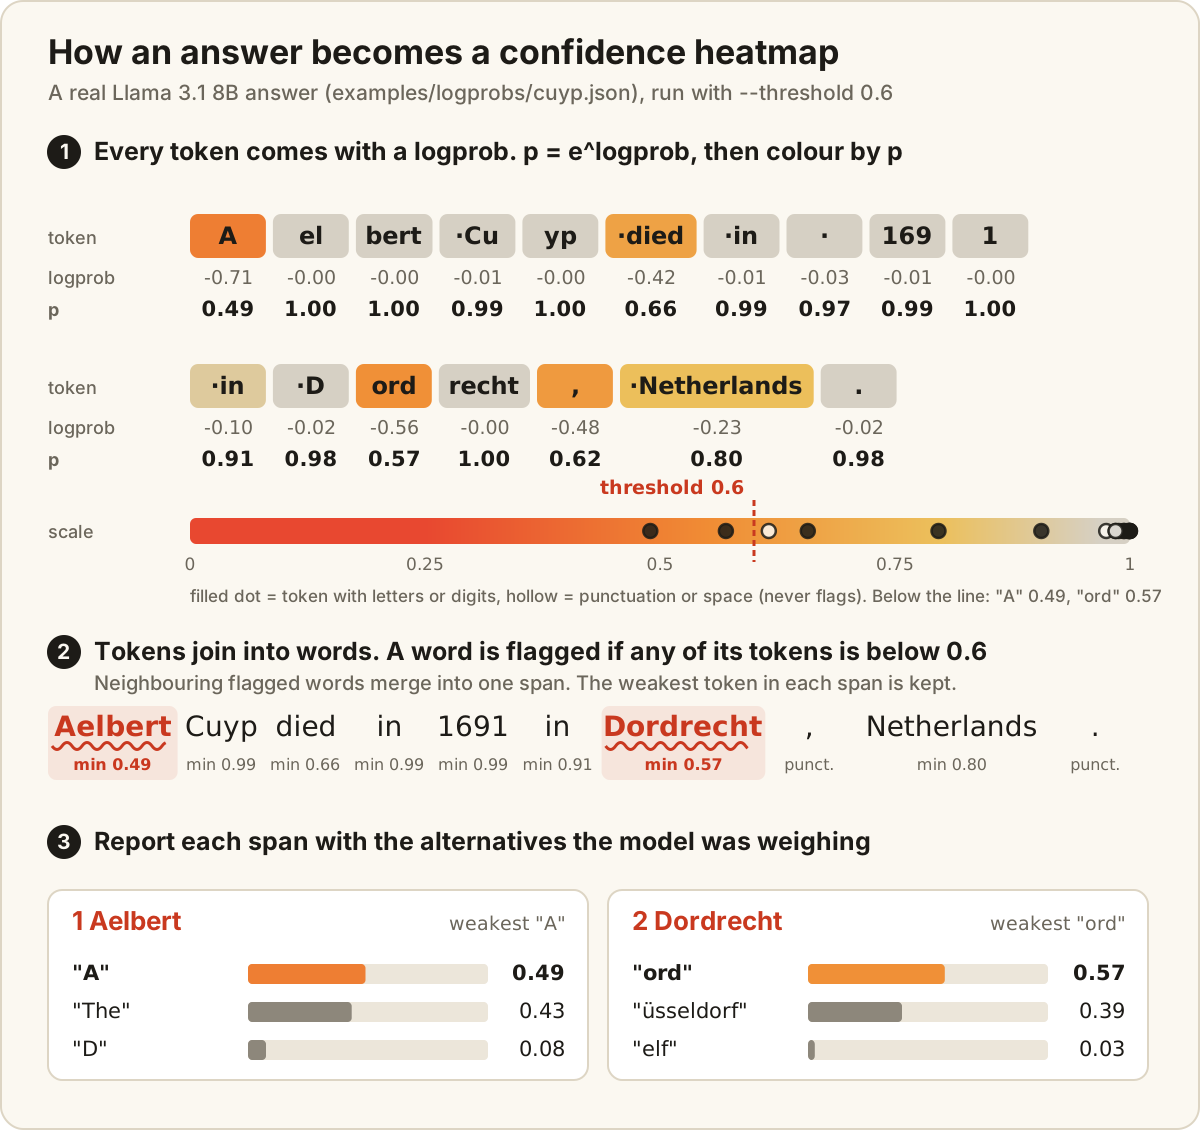
ルールは四つだけ。独自のモデルは使いません。

別の LLM も、埋め込みも、オフラインモードでのネットワーク通信もなし。モデルがすでに返している数値を丁寧に読むだけです。

アニメーション図:実際の Llama 3.1 の回答の各トークンに p = e^logprob と赤からグレーまでの色が付く。トークンが単語にまとまり、しきい値 0.6 を下回るトークンを含む単語にフラグが付く(Aelbert p 0.49、Dordrecht p 0.57)。フラグ付きの各スパンにはモデルが検討した候補 The 0.43 と üsseldorf 0.39 が並ぶ。
わからないこと

モデルは自信満々に間違えることがある。

トークン確率の低さは「見るべき場所」を示すだけで、ファクトチェックではありません。この同梱の回答は間違っていますが、検出ツールは見抜けません。

間違った名前にはフラグが付かない

月面を歩いた二人目は Buzz Aldrin です。モデルは Pete Conrad のどのトークンにも 0.72 以上の確率を付けており、どの位置で返された上位 3 つの候補にも Aldrin は入っていません。

代わりにフラグが付いたもの

言い回しの単語です。フラグは最初にどこを確認するか決めるために使い、回答の正しさの保証には決して使わないでください。

出力形式

ターミナル、HTML、Markdown、JSON。

同じレポートを、ワークフローに合った形で。どれも CLI が同じ検出結果から出力します。

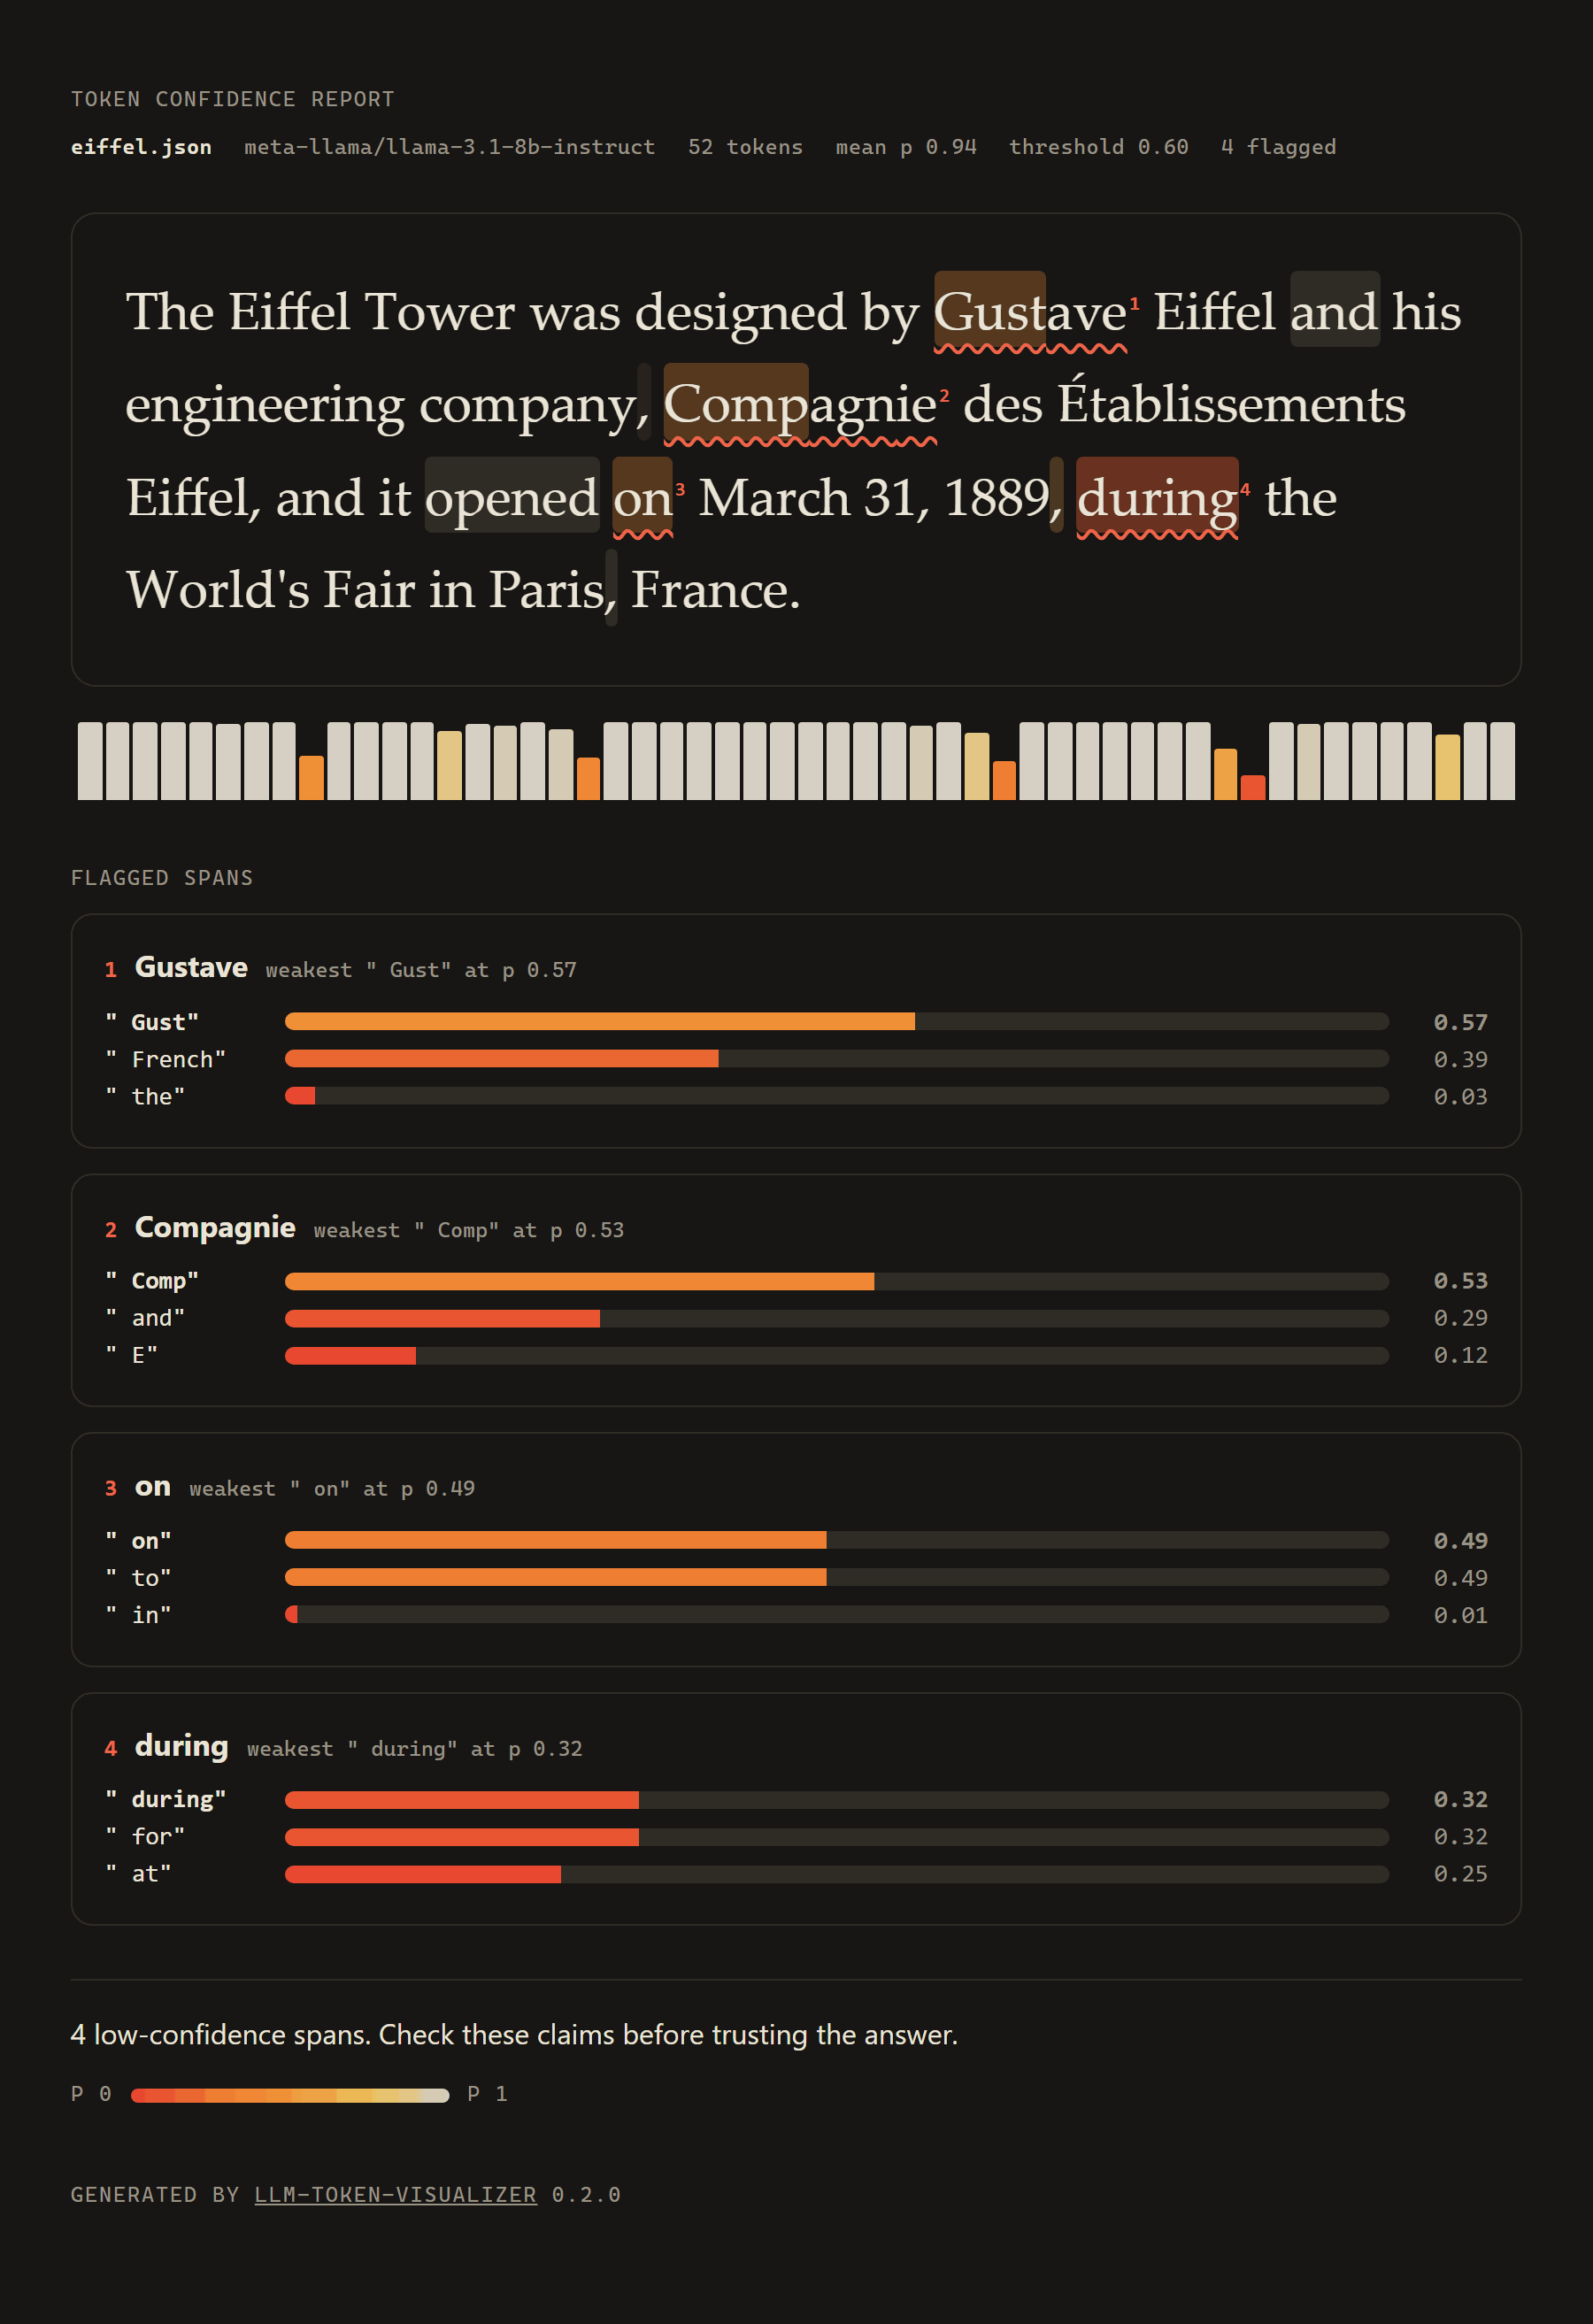
--format html

単体で完結するページ。スクリプトも外部アセットもなし、ライト/ダーク両対応。単語にカーソルを合わせると候補が出ます。

eiffel サンプルのダークモード HTML レポート。フラグ付きスパン 4 つと確率バー。
llm-token-visualizer --logprobs-file answer.json --format html -o report.html

--format markdown

プルリクエストや Issue、$GITHUB_STEP_SUMMARY にそのまま貼り付けられます。


--format json と --fail-on-flag

機械可読なスパンを出力し、何かにフラグが付けば終了ステータス 2 を返すので、パイプラインで回答をレビューに回せます。

llm-token-visualizer --logprobs-file answer.json \
  --fail-on-flag --format json -o report.json